Trzecia część serii o warstwach, w których to, co widzisz w panelu, nie odpowiada temu, co wychodzi na zewnątrz. W pierwszej była baza. W drugiej kod strony. Teraz dane produktowe — i tym razem nikt nie popełnił błędu.
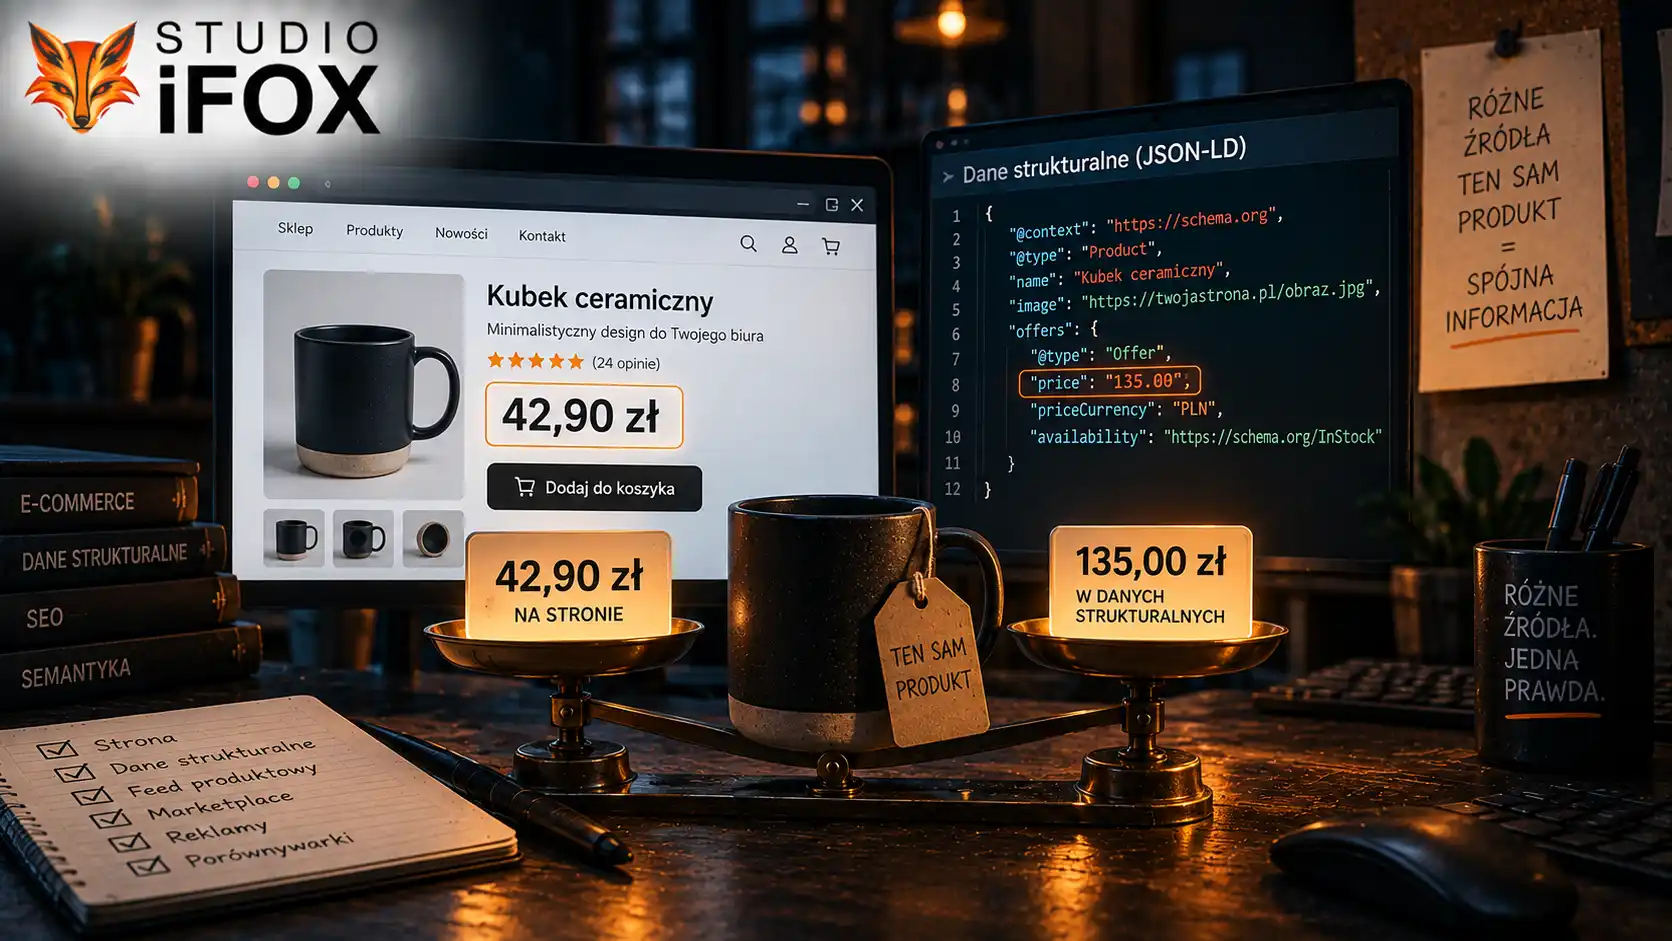
Strona produktu w sklepie jednej z polskich palarni kawy. Kawa ziarnista, opakowanie 250 g. Na stronie, w miejscu przeznaczonym na cenę, widać 42,90 zł.
W danych strukturalnych osadzonych w tym samym dokumencie — tych, z których korzystają wyszukiwarki i asystenci zakupowi — pierwsza oferta w kolejności to 135,00 zł.
Trzykrotna różnica na tej samej stronie, w tej samej chwili.
I rzecz najważniejsza: sklep nie zrobił niczego źle. Znacznik jest kompletny, poprawny i zgodny ze specyfikacją. Walidator nie zgłosi zastrzeżeń. Żadne standardowe narzędzie diagnostyczne nie wskaże tu problemu, bo problemu — w sensie, w jakim zwykle go rozumiemy — nie ma.
Skąd bierze się ta różnica
Produkt występuje w czterech gramaturach. W danych strukturalnych zapisano to jako grupę produktów z wariantami:
250 g   →  42,90 zł
500 g   →  76,90 zł
3 kg    → 135,00 zł
5 kg    → 364,90 zł
To jest prawidłowy sposób opisania produktu wariantowego i dokładnie ten, który rekomendują wyszukiwarki. Wszystkie cztery ceny są prawdziwe.
Problem polega na tym, czego w tym zapisie nie ma: jednoznacznego wskazania, który wariant odpowiada temu konkretnemu adresowi. Strona dotyczy opakowania 250 g. Grupa zawiera cztery warianty, a ten ze 135 zł jest w kolejności pierwszy.
Odbiorca, który rozumie strukturę grupy i dopasuje wariant do adresu, poda 42,90 zł. Odbiorca, który bierze pierwszą ofertę z brzegu — bo tak jest prościej i tak robi większość prostych integracji — poda 135,00 zł.
Obaj czytają ten sam, poprawny dokument. Dostają różne odpowiedzi.
Jeden produkt, cztery źródła — na razie
W panelu sklepu produkt ma jedną cenę i jeden stan magazynowy. To jest źródło, do którego zaglądasz i na podstawie którego oceniasz, że wszystko się zgadza.
Na zewnątrz ten sam produkt występuje w co najmniej czterech miejscach, a każde powstaje w innym momencie i innym mechanizmem:
Strona produktu — HTML generowany przy żądaniu, zwykle z warstwą pamięci podręcznej po drodze.
Dane strukturalne — blok opisujący produkt dla maszyn, osadzony w tej samej stronie, ale generowany przez inną wtyczkę i często z innego zestawu pól.
Feed produktowy — plik dla porównywarek i reklam, budowany cyklicznie, zwykle raz na dobę.
Interfejs programistyczny sklepu — to, co zwraca REST API, gdy pyta o ten sam produkt zewnętrzna integracja.
A lista się wydłuża. Do tych czterech dochodzą właśnie kolejne: serwer MCP wystawiający katalog bezpośrednio agentom, NLWeb jako warstwa odpytywania sklepu językiem naturalnym i protokoły agentic commerce, przez które asystent zakupowy ma nie tylko obejrzeć produkt, ale go kupić.
Każde nowe źródło to kolejne miejsce, w którym ta sama prawda może się rozjechać. Dziś rozjeżdżają się cztery. Za rok będzie ich sześć albo siedem — a mechanizm ich synchronizacji pozostanie ten sam co dziś, czyli żaden, bo każde powstaje osobno.
Skąd biorą się rozbieżności
Żadna z poniższych przyczyn nie jest błędem w kodzie. Wszystkie są konsekwencją tego, że dane powstają w różnych momentach i z różnych pól.
Warianty upraszczają się różnie. To jest przypadek opisany wyżej i najczęstszy ze wszystkich. Produkt w czterech gramaturach ma cztery ceny. Strona pokazuje jedną, feed wymaga jednej wartości na pozycję, dane strukturalne dopuszczają grupę. Każde z tych miejsc upraszcza inaczej i każde ma rację na swoich zasadach.
Feed jest zdjęciem, nie lustrem. Generuje się raz na dobę i od tej chwili opisuje stan sprzed generowania. Zmiana ceny o dziesiątej rano trafia do feeda następnego dnia.
Strona ma pamięć podręczną, feed ma inną albo nie ma żadnej. Przy agresywnym cache'owaniu strona potrafi przez godziny pokazywać cenę sprzed zmiany, podczas gdy feed wygenerowany w międzyczasie ma już nową. Dwa źródła rozjeżdżają się w przeciwne strony.
Dane strukturalne powstają z innego zestawu pól niż feed. Wtyczka do danych strukturalnych bierze cenę z jednego pola, wtyczka do feeda z innego. Przy produkcie prostym dają ten sam wynik. Przy promocji albo cenie „od" — niekoniecznie.
Dostępność liczy się według różnych reguł. Stan magazynowy zero przy włączonych zamówieniach oczekujących to dla sklepu „dostępny na zamówienie", dla feeda zwykle „niedostępny", a dla danych strukturalnych zależnie od konfiguracji jedno albo drugie.
Czwarta diagnoza: karta niejednoznaczna
W serii o skanerze gotowości sklepu na agentów opisywaliśmy trzy stany, w jakich zastaje się kartę produktu:
Karta uboga — dane są, ale nie odpowiadają na pytania klienta. Karta rozsypana — dane są, ale rozrzucone tak, że nie da się ich powiązać. Karta niewidoczna — dane dochodzą dopiero po wykonaniu skryptów, więc dla części odbiorców nie istnieją.
Przypadek z początku tego tekstu nie mieści się w żadnym z nich. Dane są kompletne, powiązane i obecne w kodzie strony. Skaner dałby tu wysoką ocenę i miałby rację.
Dlatego dopisujemy czwarty stan: karta niejednoznaczna. Dane są poprawne, a mimo to dwa różne odbiorniki odczytają z nich dwie różne wartości — bo dokument dopuszcza więcej niż jedną poprawną interpretację.
Różnica wobec trzech poprzednich jest zasadnicza. Tamte dotyczą danych i naprawia się je, uzupełniając albo przenosząc. Ta dotyczy odczytu i naprawia się ją, zawężając pole interpretacji — wskazując wprost, który wariant odpowiada której stronie, zamiast liczyć, że odbiorca się domyśli.
I to jest stan, którego będzie przybywać, nie ubywać. Im więcej odbiorców i im bardziej różnią się między sobą, tym większa szansa, że ten sam dokument zostanie przeczytany na kilka sposobów.
Dlaczego to ma znaczenie — i dla kogo
Porównywarki i reklamy. Rozbieżność między ceną w feedzie a ceną na stronie docelowej jest jedną z najczęstszych przyczyn odrzucenia produktu albo zawieszenia konta w systemach reklamowych. Nie chodzi o karę za błąd, tylko o to, że użytkownik kliknął w jedną cenę i zobaczył inną.
Asystenci zakupowi. Model porównujący produkty w imieniu użytkownika nie ogląda strony tak jak człowiek. Czyta dane strukturalne albo feed — czyli dokładnie te źródła, które rozjeżdżają się najczęściej i o których właściciel sklepu wie najmniej. A w porównaniu cenowym produkt za 135 zł przegrywa z konkurencją, która ten sam towar sprzedaje po 42,90.
Zaufanie. Konsekwencja, której nie widać w żadnym raporcie. Klient, który trafił z porównywarki na inną cenę, nie zgłasza reklamacji. Zamyka kartę.
Naprawa ma swoją kolejność
Tak samo jak w dwóch poprzednich częściach: najpierw źródło, potem skutki.
Ustal, które źródło jest nadrzędne. W wielu sklepach nie jest to ustalone, bo feed konfigurowała agencja reklamowa, dane strukturalne wtyczka SEO, a cenę zmienia się w panelu. Bez jednego źródła prawdy każda naprawa będzie prowizoryczna.
Zawęź interpretację przy wariantach. Jeśli strona dotyczy konkretnego wariantu, dane strukturalne powinny wskazywać ten wariant jako główny — a nie zostawiać odbiorcy wybór spośród czterech. To zmiana konfiguracyjna, nie programistyczna, i daje efekt natychmiast.
Zsynchronizuj momenty generowania. Feed budowany częściej, cache unieważniany przy zmianie ceny, dane strukturalne pobierane z tego samego pola co feed.
Domknij reguły dla przypadków niejednoznacznych. Ceny „od", zamówienia oczekujące, promocje czasowe. Każdy wymaga świadomej decyzji, jak ma być reprezentowany w każdym ze źródeł — bo domyślne zachowania wtyczek bywają sprzeczne.
Dopiero na końcu popraw pojedyncze produkty. Bez czterech poprzednich kroków rozbieżności wrócą przy najbliższej zmianie cennika.
Jak sprawdzić własny sklep
Dwa źródła z czterech da się sprawdzić z zewnątrz, bez dostępu do panelu i bez instalowania narzędzi: stronę i dane strukturalne. To akurat ta para, z której korzystają asystenci zakupowi.
Poniższa komenda wyciąga z adresu produktu wszystkie ceny zadeklarowane w danych strukturalnych, razem z wariantami:
curl -s --compressed ADRES_PRODUKTU | python3 -c "
import sys, re, json
h = sys.stdin.read()

def obiekty(o):
    if isinstance(o, dict):
        yield o
        for v in o.values(): yield from obiekty(v)
    elif isinstance(o, list):
        for v in o: yield from obiekty(v)

widziane = set()
for b in re.findall(r'<script[^>]*ld\+json[^>]*>(.*?)</script>', h, re.S):
    try: d = json.loads(b)
    except Exception: continue
    for o in obiekty(d):
        if 'Product' not in str(o.get('@type','')): continue
        of = o.get('offers') or {}
        of = of[0] if isinstance(of, list) else of
        if not isinstance(of, dict) or not of.get('price'): continue
        if of['price'] in widziane: continue
        widziane.add(of['price'])
        print(of.get('price'), of.get('priceCurrency',''),
              '|', o.get('size') or o.get('sku') or '')
"

135.00 PLN | 1 kg
42.90 PLN | 250 g
364.90 PLN | 3 kg
76.90 PLN | 500 gTrzy rzeczy do sprawdzenia w wyniku:
Czy cokolwiek się wyświetliło. Pusto oznacza, że maszyna nie ma skąd wziąć ceny i musi odczytać ją z treści strony — z całą niepewnością, jaka się z tym wiąże.
Czy pierwsza wartość zgadza się z tym, co widać na stronie. Jeśli nie, masz przypadek opisany w tym tekście.
Czy wariantów jest więcej niż jeden. Jeśli tak, sprawdź, czy z dokumentu wynika, który dotyczy tego adresu.
Jedna uwaga techniczna dla tych, którzy będą to automatyzować: przełącznik --compressed jest tu istotny. Bez niego część serwerów odda dokument nieskompresowany, a część bibliotek HTTP nie rozpakuje odpowiedzi w formacie Brotli i dostaniesz śmieci zamiast kodu strony — o czym pisaliśmy w drugiej części tej serii.
Sprawdzenie poglądowe, bez komend. Weź pięć produktów: jeden prosty, jeden z wariantami, jeden na promocji, jeden z zerowym stanem i jeden najdroższy w katalogu. Dla każdego zapisz cenę i dostępność z czterech źródeł. Pięć produktów razy cztery źródła to dwadzieścia pól i kwadrans pracy. Rozbieżności, jeśli są, pojawią się przy drugim i czwartym.
To trzecia część serii
Cztery warstwy, w tej samej kolejności, w jakiej je sprawdzamy:
- Baza danych — co siedzi w tabelach i ile z tego jest treścią. (część pierwsza)
- Struktura strony — co widzi crawler, a czego nie widzi. (część druga)
- Dane produktowe — spójność katalogu, feeda i tego, co jest na stronie. (ten tekst)
- Schema — czy maszyny mają skąd wziąć fakty o firmie.
W pierwszej części problem ukrywał kokpit, pokazując liczbę wpisów zamiast ich rozmiaru. W drugiej kompresja, pokazując transfer zamiast dokumentu. W tej ukrywa go panel produktu — pokazuje jedną poprawną wartość, przez co nie ma powodu podejrzewać, że na zewnątrz jest ich kilka.
Ale tym razem dochodzi coś, czego w dwóch poprzednich nie było. Tam istniał błąd do znalezienia i naprawienia. Tutaj wszystko jest poprawne i mimo to nie działa tak, jak powinno — bo poprawność danych i jednoznaczność ich odczytu to dwie różne rzeczy, a narzędzia sprawdzają wyłącznie pierwszą.
Dlatego sprawdzamy to przy każdym projekcie
Rozbieżności w danych produktowych nie dają komunikatu o błędzie. Sklep działa, zamówienia przechodzą, panel wygląda poprawnie, walidator nie zgłasza uwag. Wychodzą dopiero wtedy, gdy ktoś porówna źródła ze sobą — albo gdy zrobi to za niego system reklamowy i zawiesi konto.
W studiu spójność danych produktowych jest częścią standardu wykonania projektu, a nie osobną usługą. Tak samo jak czytelna struktura dokumentu, dostępność i poprawne dane strukturalne. Sprawdzamy to przy budowie i przy przebudowie, bo poprawienie później kosztuje więcej niż ustawienie od razu.
FAQ
Czy rozbieżność między feedem a stroną zawsze jest błędem? Nie. Feed jest zdjęciem stanu z momentu generowania i pewne opóźnienie jest wpisane w mechanizm. Problemem jest rozbieżność utrzymująca się dłużej niż jeden cykl generowania albo taka, o której nikt nie wie.
Czy grupa produktów z wariantami to zły sposób opisu? Nie, to sposób rekomendowany. Problem nie leży w samej strukturze, tylko w tym, że przy wielu wariantach warto wskazać, który odpowiada bieżącej stronie — inaczej prostszy odbiornik weźmie pierwszy z brzegu.
Czy dane strukturalne muszą zgadzać się z ceną na stronie? Tak, i to jest wymóg, nie zalecenie. Rozbieżność między danymi strukturalnymi a tym, co widzi użytkownik, bywa traktowana jako wprowadzanie w błąd — niezależnie od tego, że wzięła się z konfiguracji, a nie ze złej woli.
Jak często powinien generować się feed? Przy stabilnym cenniku raz na dobę wystarcza. Przy częstych promocjach albo szybkiej rotacji magazynu dobowy feed jest za wolny i warto rozważyć aktualizacje przyrostowe.
Czy asystenci AI korzystają z feeda? Część tak, część czyta dane strukturalne ze strony, część jedno i drugie, a najnowsze sięgają po dedykowane interfejsy. Z punktu widzenia sklepu to nie zmienia zalecenia: wszystkie źródła powinny mówić to samo, co panel.
Czy to dotyczy tylko sklepów na WordPressie? Nie. Przypadek opisany w tym tekście pochodzi ze sklepu zbudowanego na zupełnie innej technologii. Mechanizm jest wspólny dla każdego sklepu, w którym dane wychodzą na zewnątrz więcej niż jednym kanałem.